CSPM para todos: detectá con Prowler y remediá con Cloud Custodian sin pagar licencias
Monté una infraestructura AWS deliberadamente vulnerable, la escaneé con Prowler y automaticé la remediación con Cloud Custodian.
I have a bachelor's degree in Technology from the University of Palermo, a Master in Information Security from the University of Murcia and different certifications such as CISSP | CISM | CDPSE | CCSK | CSX | MCSA | SMAC™️ | DSOE | DEPC | CSFPC | CSFPC | 5x AWS Certified.
He is currently CISO at Klar, a Mexican Fintech. He was fortunate to be awarded as CISO of the Year in Argentina in 2021 and was among the Top 100 CISO's in the World in 2022.
A lover of new technologies, he has developed a career in DevSecOps and Cloud Security at Eko Party, the largest security conference in Latin America.
Monté una cuenta de AWS a propósito mal configurada, la escaneé con Prowler y dejé que Cloud Custodian remediara lo que pudiera solo. Resultado: 10 checks fallando, 5 resueltos automáticamente en menos de 3 minutos, 0 crítico al final. La otra mitad no se pudo resolver sin una persona mirando, y eso no es un problema del proyecto: es la línea real entre lo que un motor de políticas puede tocar y lo que no.
Las plataformas comerciales de CSPM cobran entre $8,000 y $40,000 al año por hacer básicamente esto: decirte qué está mal configurado y, opcionalmente, arreglarlo. El detector y el motor de remediación que usan por debajo son, en su mayoría, capas sobre herramientas open source. Armé el ciclo completo con dos de ellas, Prowler y Cloud Custodian, para ver qué tan lejos llega la versión gratis.
Qué hace falta para armar esto
CSPM (Cloud Security Posture Management) es la categoría de herramienta que audita tu cuenta cloud contra benchmarks como CIS o PCI-DSS y avisa cuándo algo quedó mal configurado: un bucket público, un security group abierto a 0.0.0.0/0, un rol con permisos que nadie pidió.
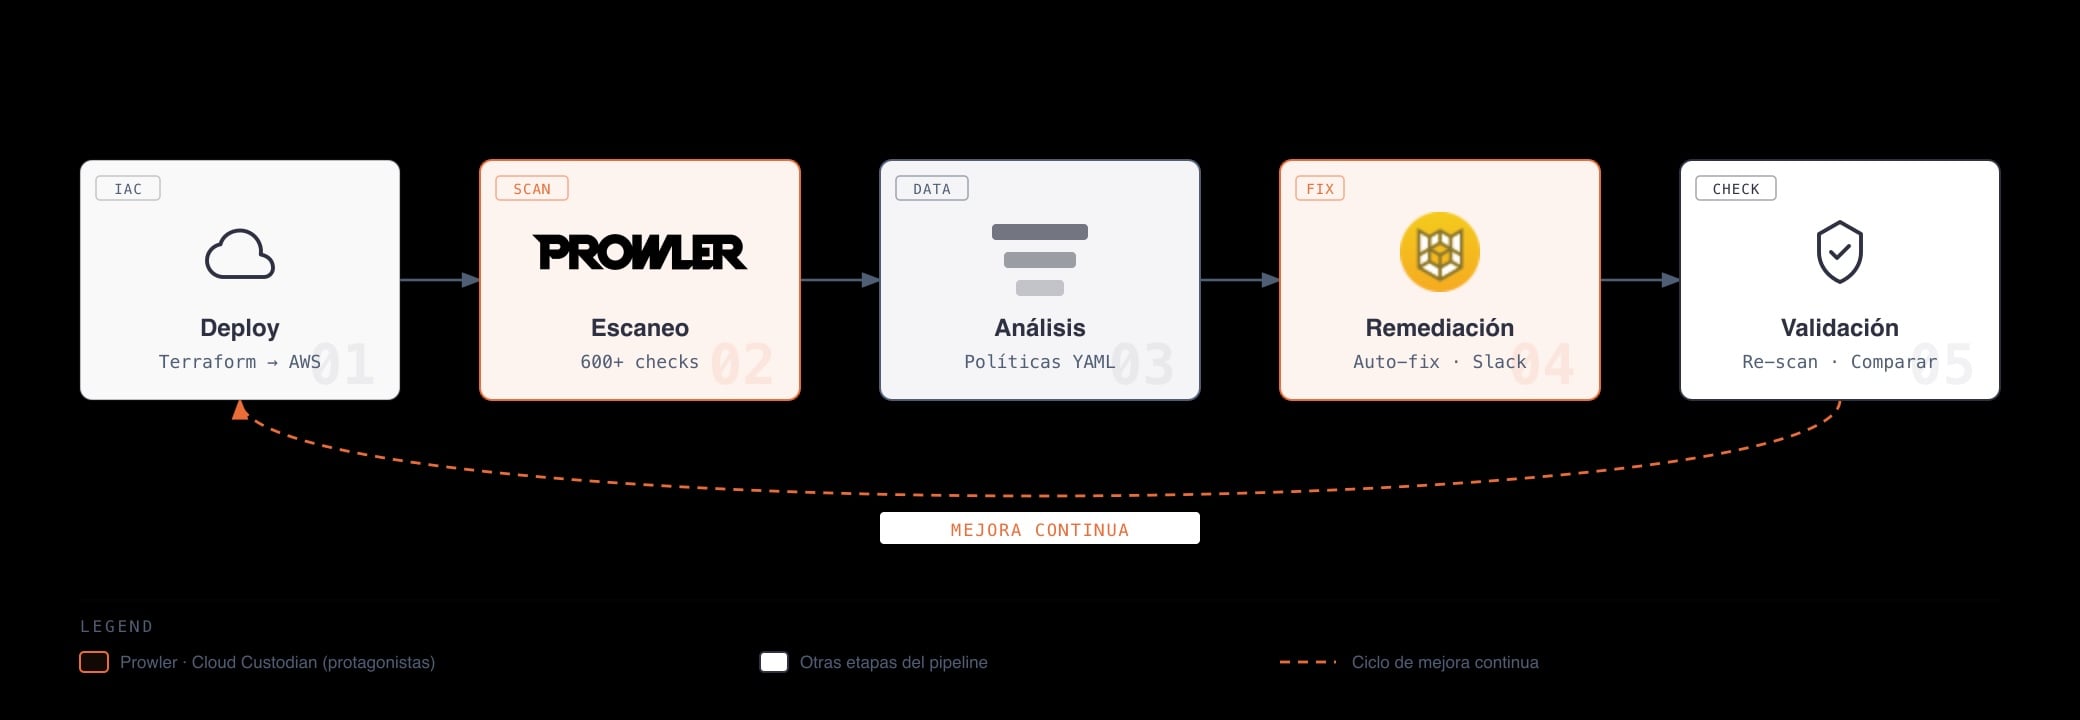
El detector (Prowler) corre más de 600 checks y es gratis. El motor de remediación (Cloud Custodian) es un sistema de políticas declarativas y también es gratis. Lo que falta no es tecnología, es alguien que arme el ciclo: escanear, priorizar, remediar, volver a escanear para confirmar que no rompiste nada.
El flujo completo, de punta a punta:
La infraestructura de prueba
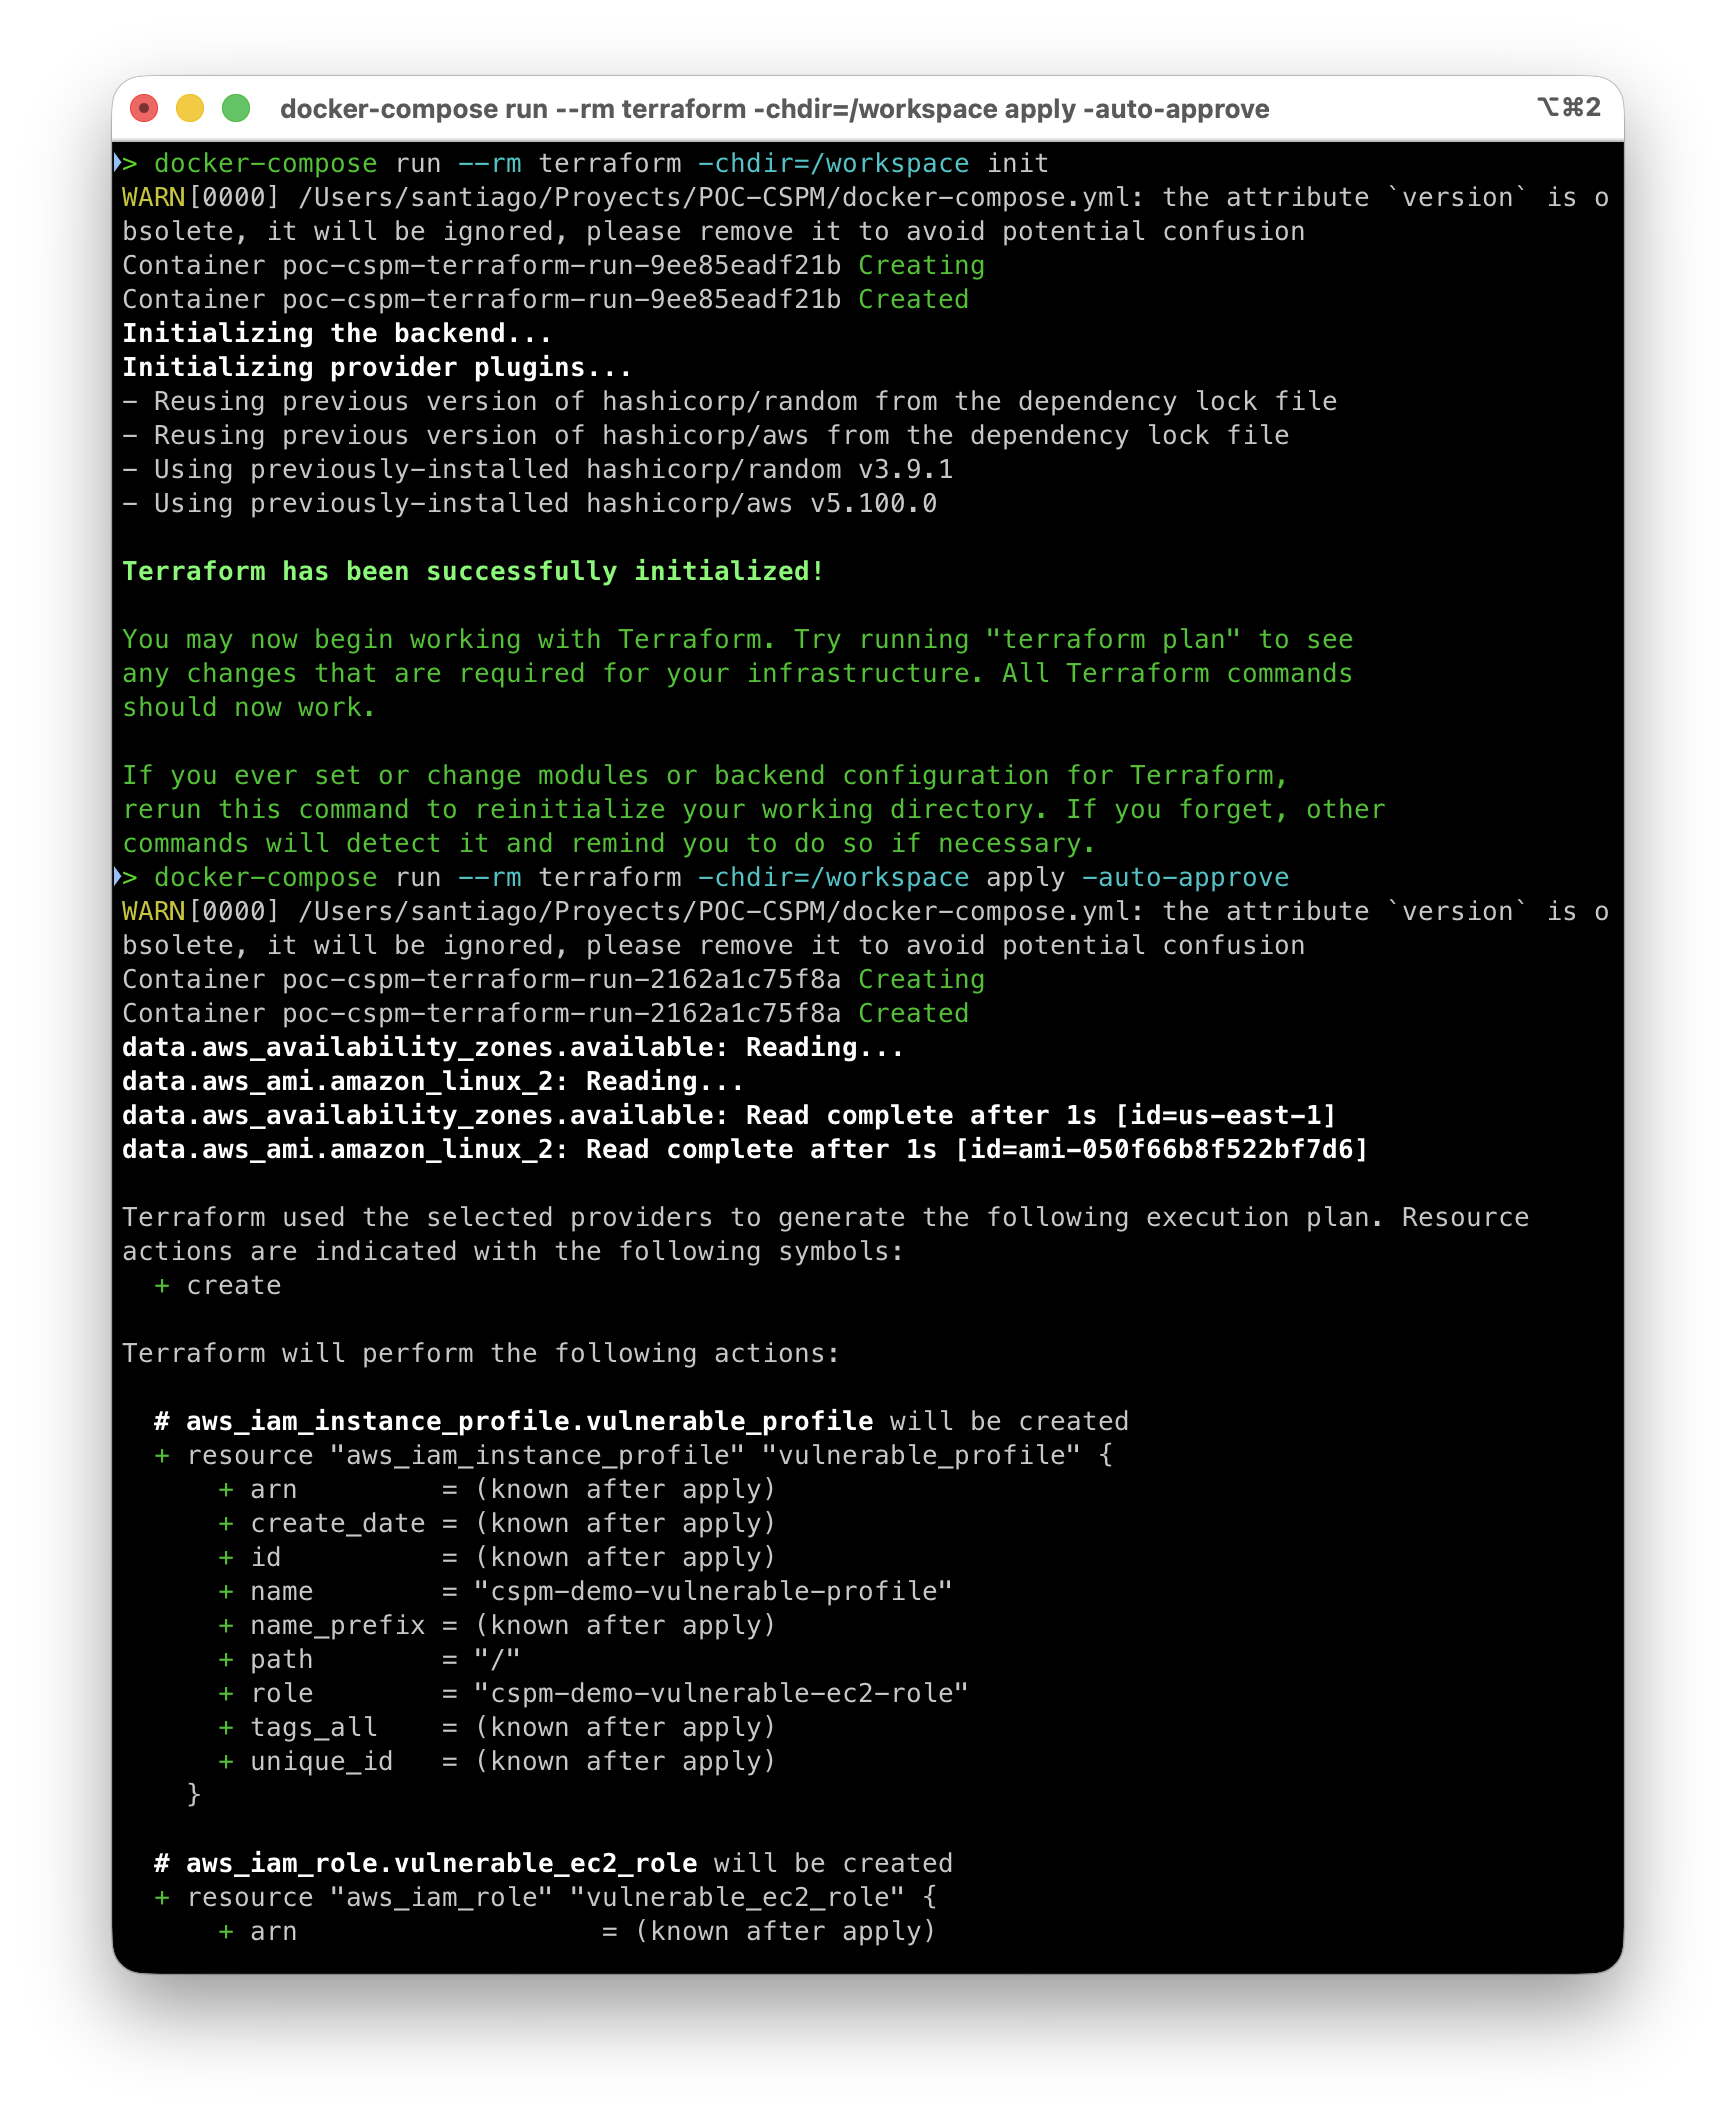
Para tener algo real que escanear, armé con Terraform una infra chica con problemas típicos de configuración:
| Recurso | Problema | Severidad |
|---|---|---|
| S3 Bucket | Público, sin encriptación, sin versionado | Critical |
| Security Group | SSH/RDP/HTTP abiertos a 0.0.0.0/0 |
Critical |
| IAM Role | AmazonS3FullAccess + AmazonEC2FullAccess |
High |
| EC2 | IMDSv1 habilitado | High |
| EBS | Volumen sin encriptar | Medium |
| VPC | Sin Flow Logs | Medium |
Cada recurso lleva el tag Project=cspm-demo. Ese tag es lo que Prowler usa para escanear solo esta demo y no toda la cuenta, y lo que Cloud Custodian usa para saber qué puede tocar. Sin un tag de aislamiento consistente, no le daría un motor de remediación automática a nada.
Voy a crearla...
Detección: 10 fallas de 96 checks
docker-compose run --rm prowler aws \
  --resource-tag Project=cspm-demo \
  --services ec2 s3 iam vpc \
  --severity critical high \
  --output-formats html csv json-ocsf
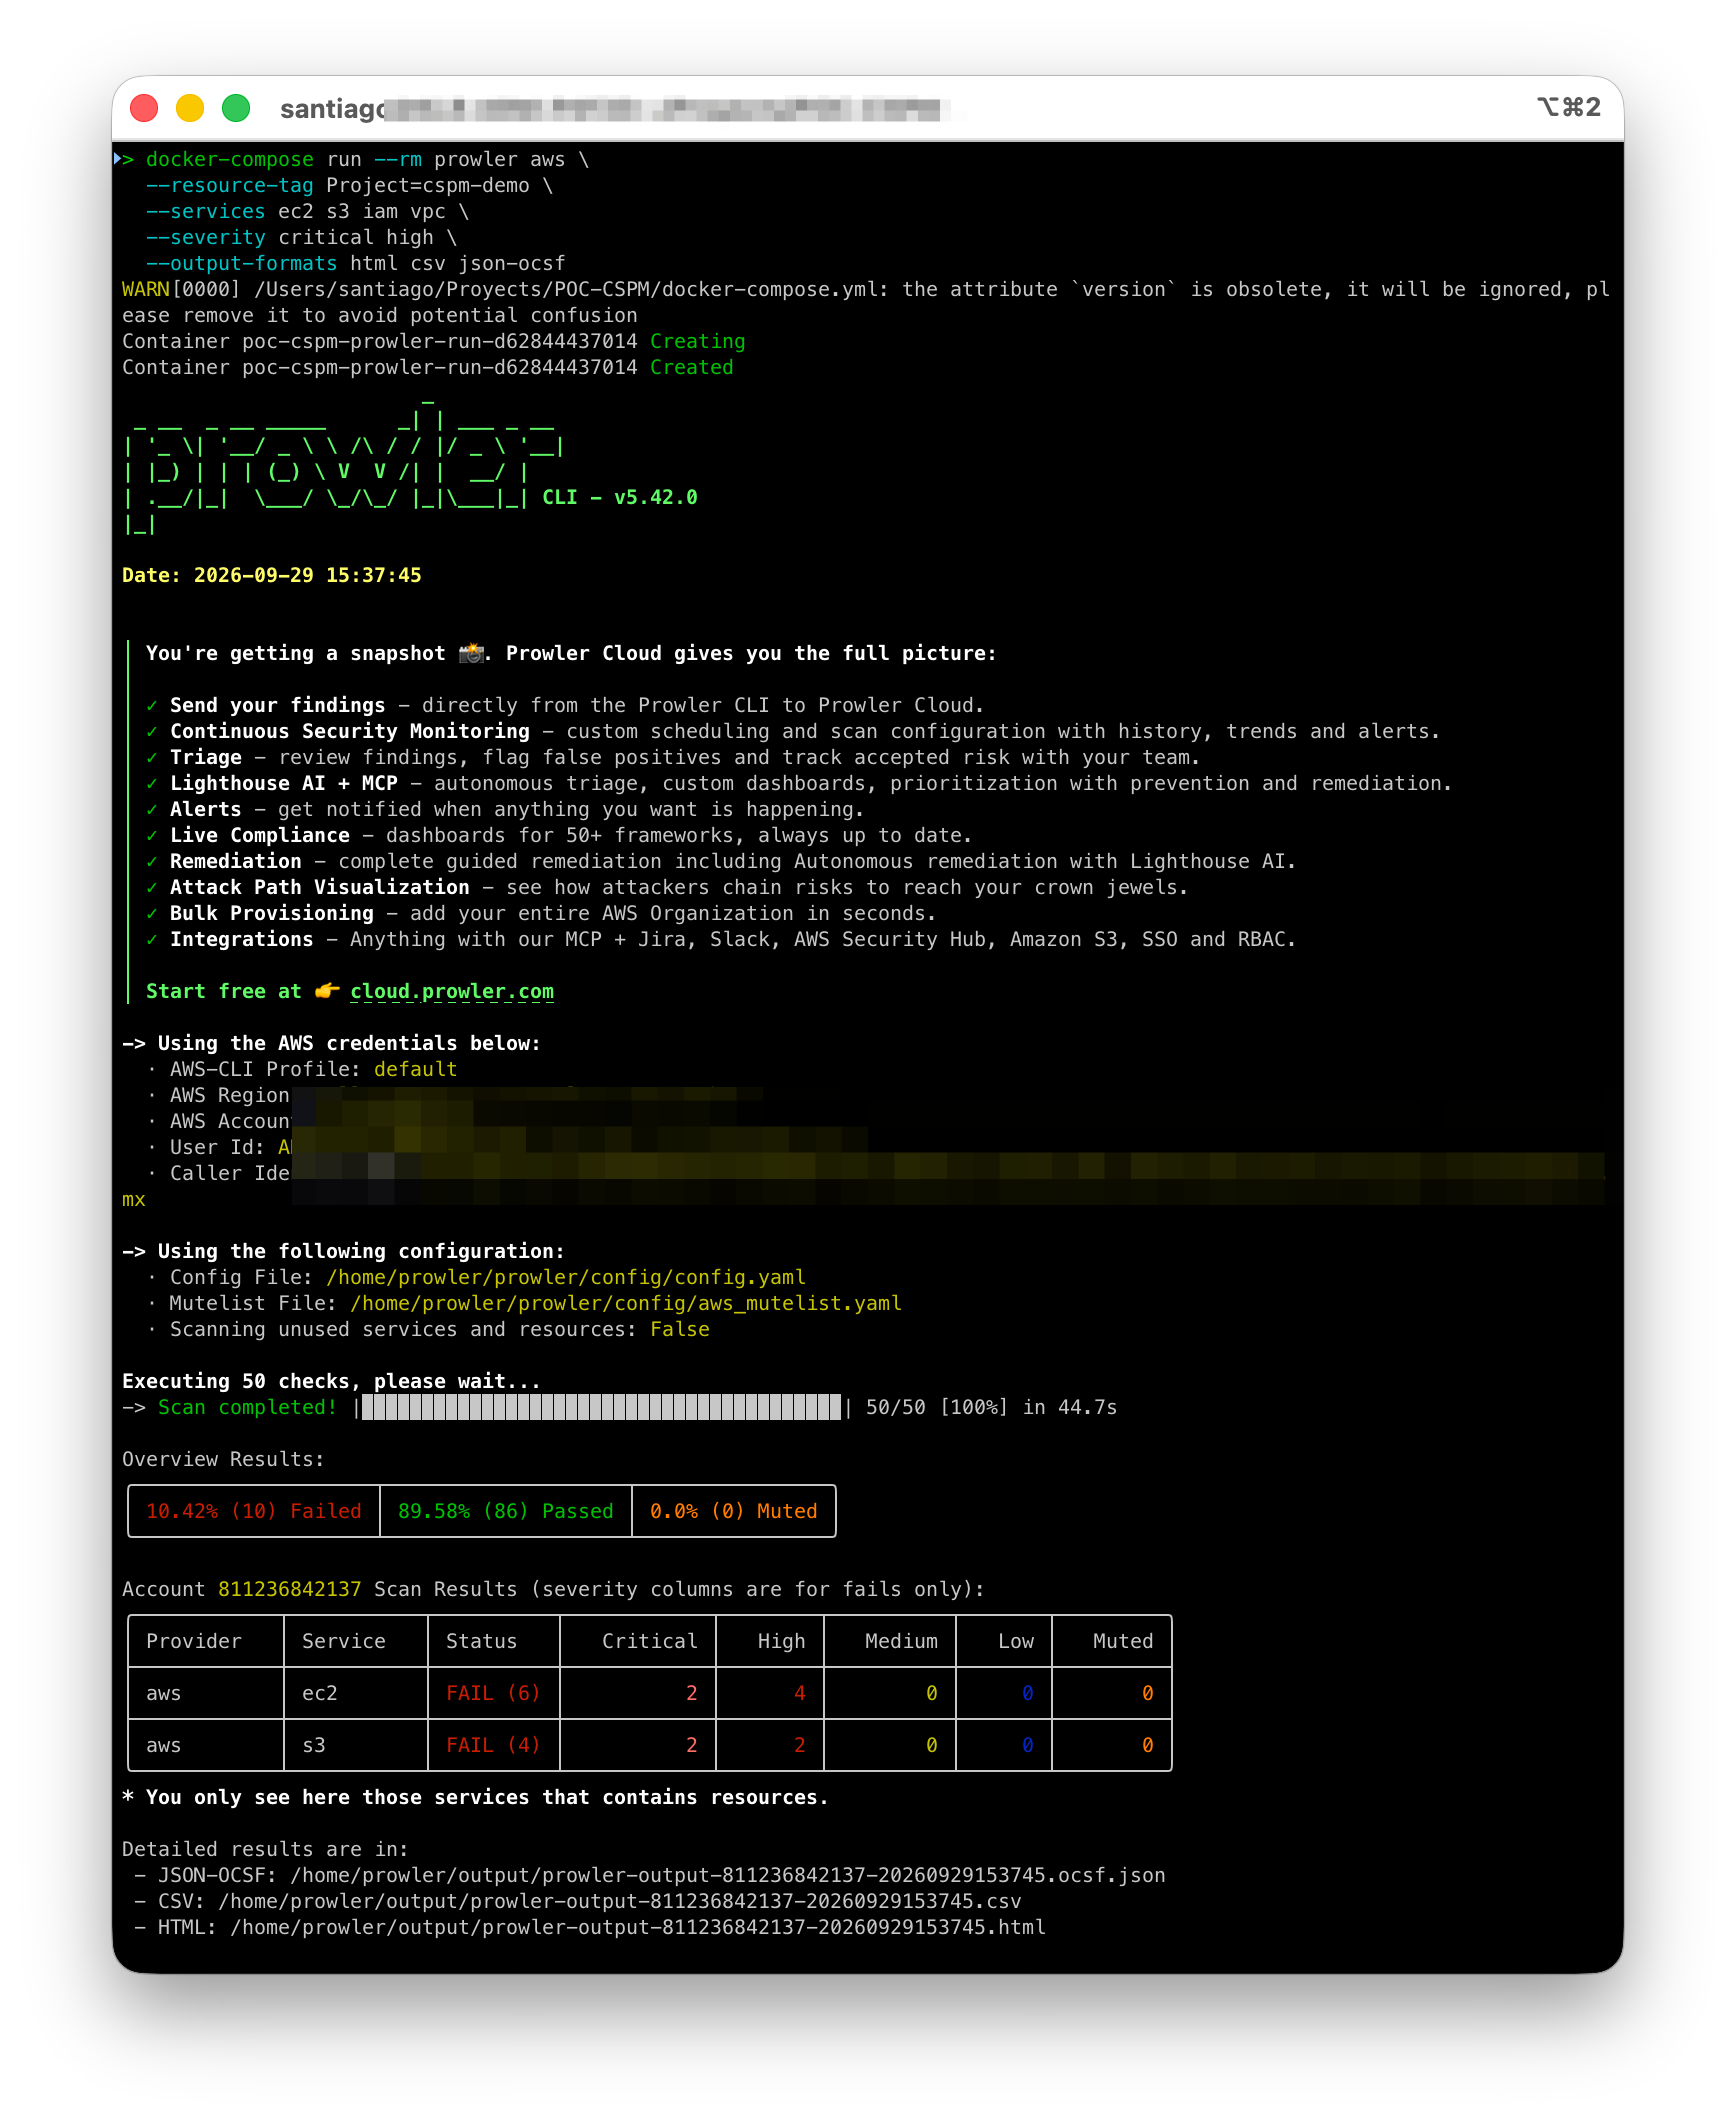
El scan inicial dio 10 de 96 checks fallando (10.42%), con 4 críticas repartidas entre EC2 (6 fallas: 2 críticas, 4 altas) y S3 (4 fallas: 2 críticas, 2 altas): security groups con SSH y RDP abiertos a internet, bucket sin Block Public Access, IMDSv1, permisos IAM excesivos.
Un detalle que me hizo perder una hora antes de confiar en estos números: el CSV que exporta Prowler usa ; como separador, y varios campos (Risk, Remediation) traen texto con saltos de línea propios. Contar hallazgos con wc -l o grep -c FAIL sobre ese archivo cuenta líneas físicas, no filas lógicas, y te da un número completamente inflado. Lo correcto es parsear el CSV como CSV:
import csv
with open(archivo, newline='') as fh:
    rows = list(csv.reader(fh, delimiter=';'))
    header, data = rows[0], rows[1:]
    idx = header.index('STATUS')
    failed = sum(1 for row in data if row[idx] == 'FAIL')
Remediación: lo que Cloud Custodian resolvió solo
Cloud Custodian es un motor de políticas: cada política es un YAML que dice "buscá recursos que cumplan esta condición, aplicales esta acción". No hay lógica custom que mantener, solo declarás la regla.
Esta cierra el puerto 22 en cualquier security group de la demo que lo tenga abierto a internet:
policies:
  - name: close-ssh-security-groups
    resource: aws.security-group
    filters:
      - tag:Project: cspm-demo
      - type: ingress
        Cidr: {value: "0.0.0.0/0"}
        Ports: [22]
    actions:
      - type: remove-permissions
        ingress: matched
docker-compose run --rm custodian run \
  -s /custodian/output \
  /custodian/policies/remediation-policies.yml
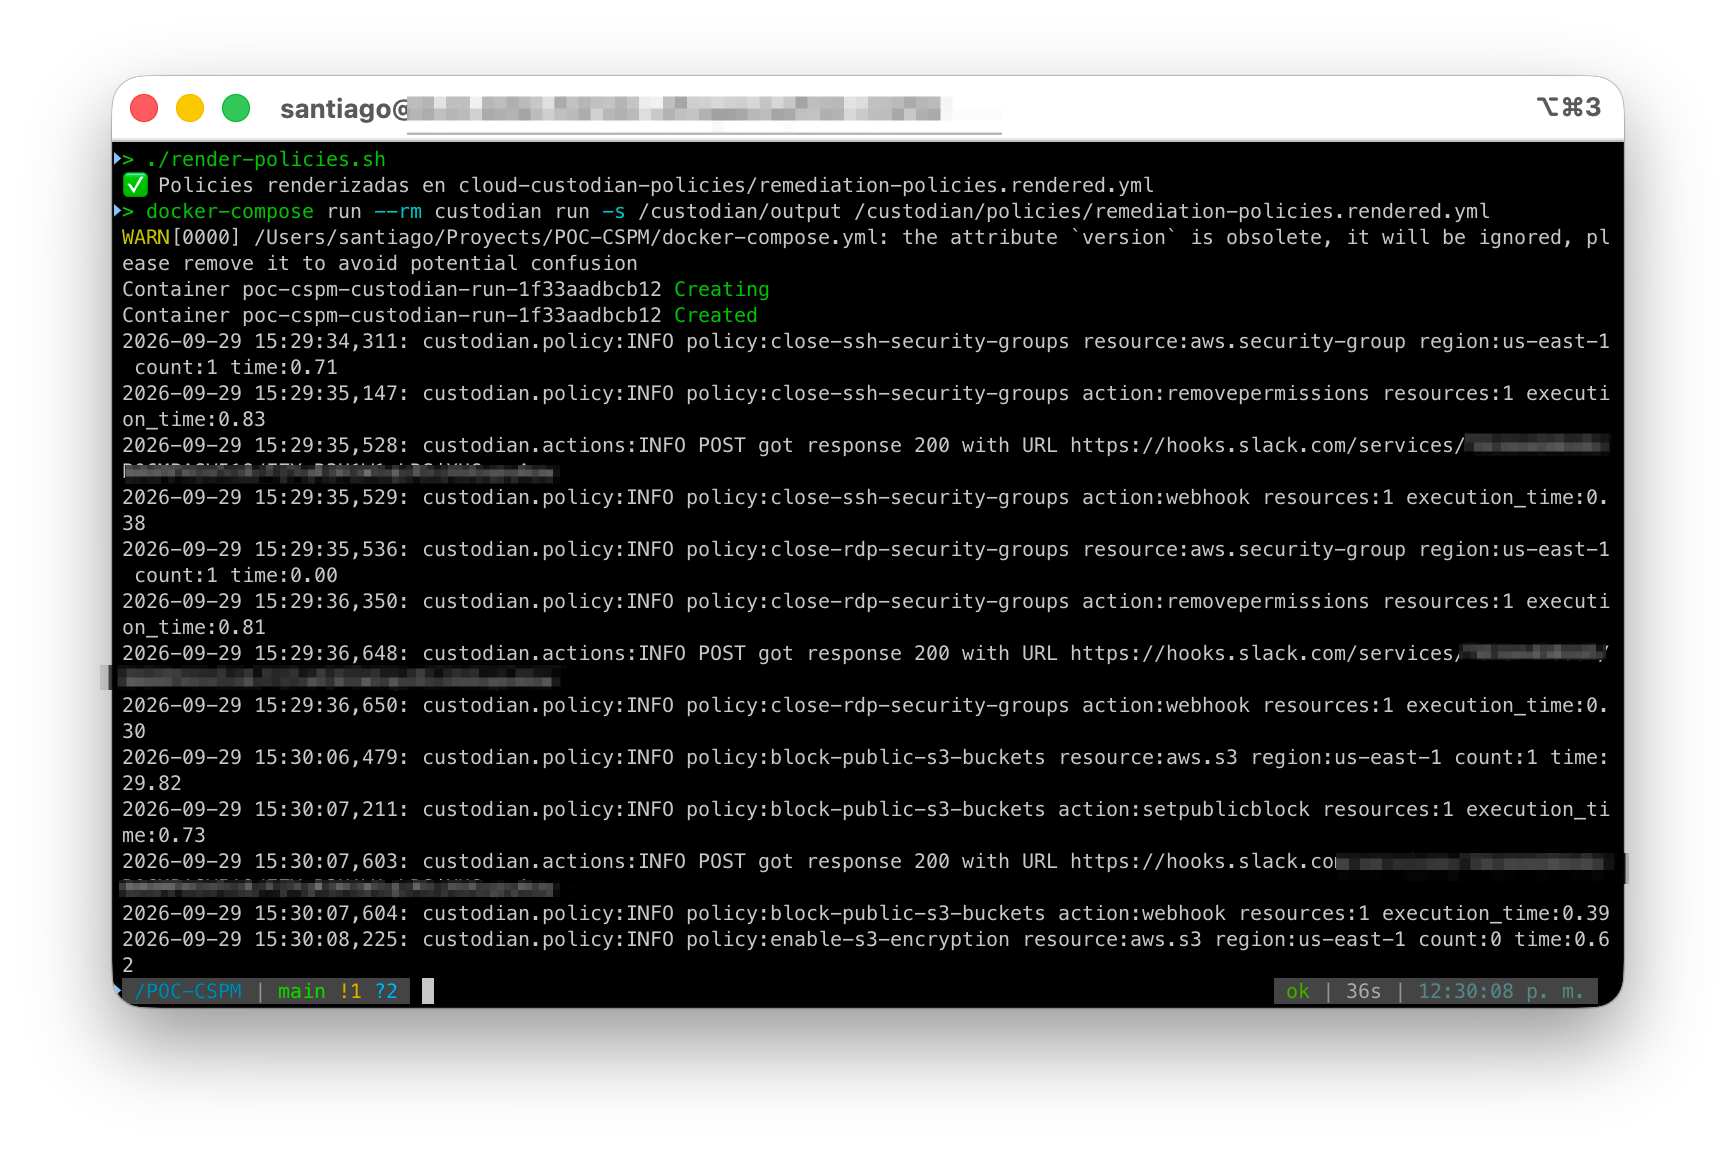
Con el set completo de políticas, en menos de 3 minutos Cloud Custodian cerró SSH y RDP abiertos a internet, y activó Block Public Access en el bucket S3. Tres remediaciones, tres recursos tocados.
Ojo con un filtro de S3 que me dio un falso negativo la primera vez que lo corrí: usar type: value contra PublicAccessBlockConfiguration.BlockPublicAcls no funciona, porque ese campo no viene poblado en el recurso base que trae Custodian. La política corría, no encontraba nada que remediar, y el bucket seguía público. El filtro correcto hace la llamada real a la API:
filters:
  - tag:Project: cspm-demo
  - type: check-public-block
Slack: una notificación por cada cosa que se tocó
Cada remediación dispara un mensaje a un incoming webhook de Slack con el recurso afectado, y al final del ciclo se manda un resumen con el antes/después. No es un extra decorativo: es la diferencia entre enterarte de que algo se arregló solo o tener que ir a revisar logs para saberlo.
Cloud Custodian no tiene un action simple para "mandame esto a un webhook de Slack". El action notify existe, pero está pensado para SNS/SQS + c7n-mailer, no para pegarle directo a una URL. Lo que sí funciona es el action genérico webhook, y su campo body no es un template de texto con variables {nombre}: es una expresión JMESPath que se evalúa contra los recursos que matchearon la policy.
actions:
  - type: remove-permissions
    ingress: matched
  - type: webhook
    url: "${SLACK_WEBHOOK_URL}"
    batch: true
    body: "{text: join('', ['🔧 Cloud Custodian cerró SSH (22) en ', to_string(length(resources)), ' security group(s): ', join(', ', resources[].GroupId)])}"
La URL del webhook no está hardcodeada en el YAML que se versiona. El archivo real usa el placeholder ${SLACK_WEBHOOK_URL}, y un script chico (render-policies.sh) lo sustituye leyendo .env (gitignored) justo antes de correr custodian run, generando un .rendered.yml que tampoco se commitea. El secreto nunca toca git.
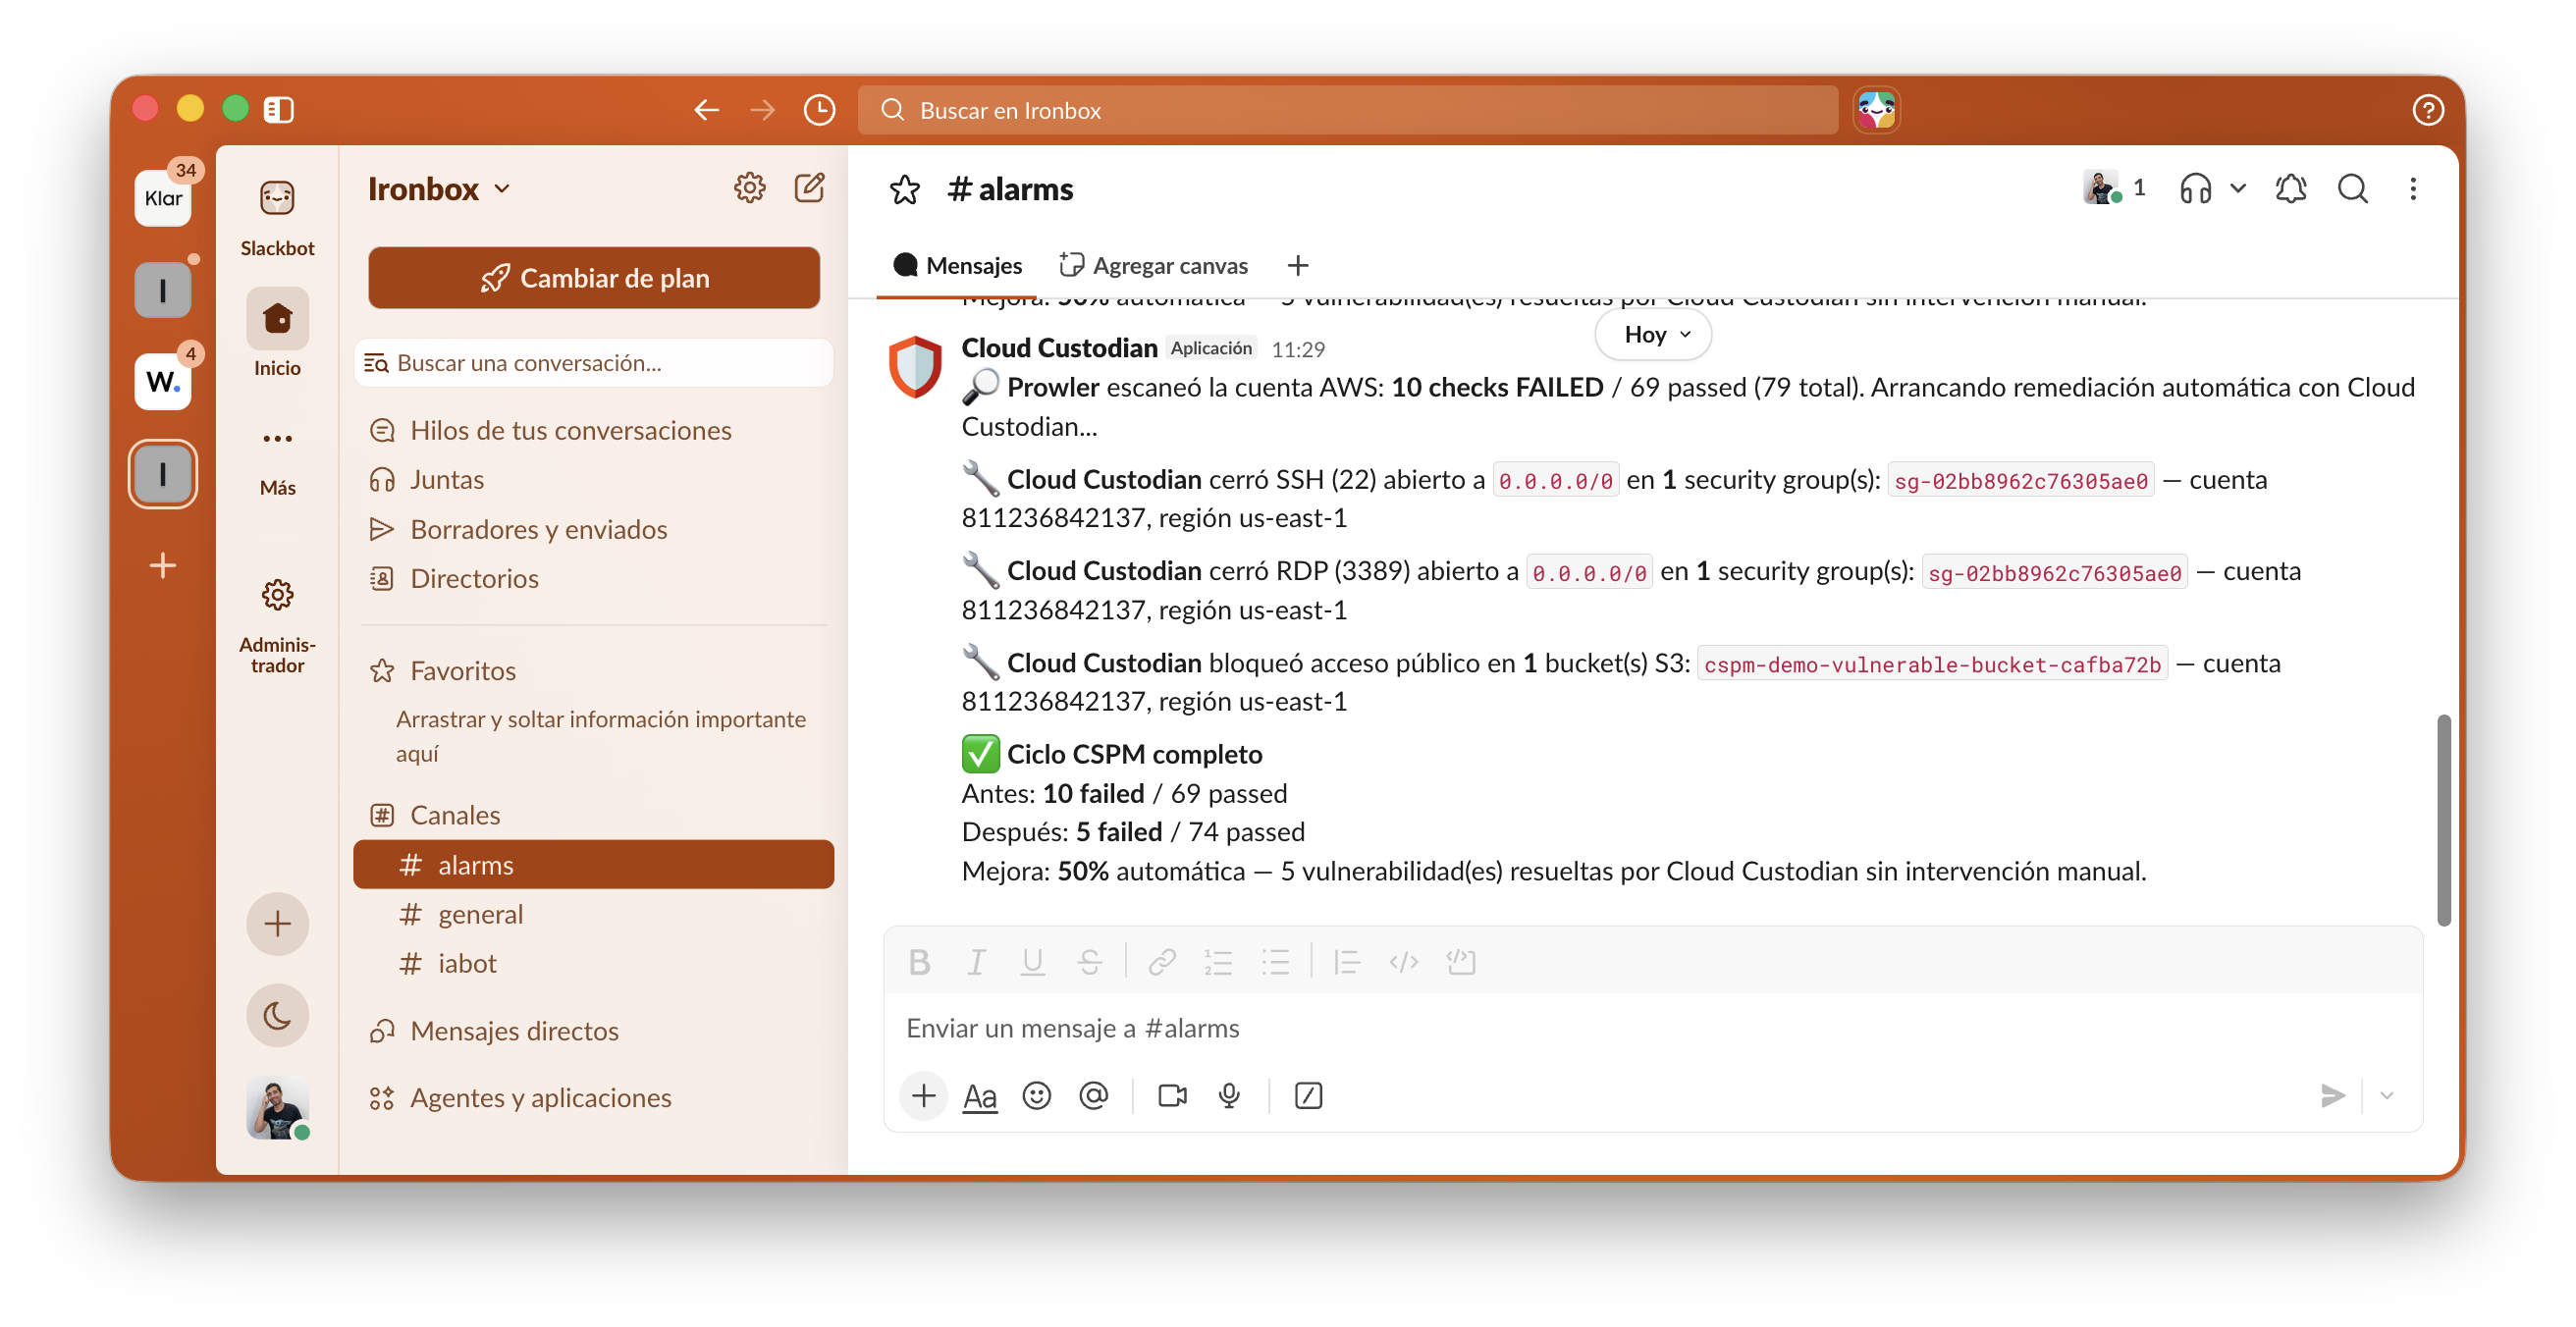
Validación: 50% de mejora, 0 críticas
Re-escaneé con el mismo comando de Prowler para confirmar que la remediación funcionó y no rompió nada:
ANTES:   10.42% failed (10 checks) — 4 críticas
DESPUÉS:  5.21% failed (5 checks)  — 0 críticas

5 vulnerabilidades resueltas automáticamente (50% de mejora)
Lo que Cloud Custodian no pudo resolver solo
De las 10 fallas iniciales, 5 quedaron pendientes. Tres categorías explican por qué, y ninguna es una limitación de la herramienta.
IMDSv1 en una instancia corriendo. Cambiar http_tokens de optional a required requiere stop/start de la instancia. Automatizar eso significa automatizar downtime, así que lo dejé fuera del scope de remediación automática a propósito.
EBS sin encriptar. No existe una operación para encriptar un volumen ya creado in-place. La única vía es snapshot → copiar el snapshot encriptado → recrear el volumen, que de nuevo implica downtime y coordinación. No es algo para correr sin supervisión.
Permisos IAM excesivos. Achicar AmazonS3FullAccess a algo mínimo requiere saber qué acciones de S3 usa realmente esa instancia. Eso es conocimiento de negocio, no algo que un motor de políticas pueda inferir. Automatizar esto a ciegas rompe cosas.
La automatización resuelve bien lo mecánico y reversible: reglas de firewall, flags de configuración, políticas de acceso. Todo lo que implica downtime o contexto de negocio sigue necesitando a alguien mirando. Eso no es una falla del sistema, es el límite correcto para ponerle a algo que corre sin supervisión.
Cómo probarlo
El código está en github.com/safernandez666/POC-CSPM, separado en dos scripts porque cumplen roles distintos.
run-cspm.sh es el demo de este repo: además del ciclo CSPM, crea y destruye con Terraform la infraestructura vulnerable de juguete que usé para tener algo que escanear. Es para probar el proyecto, no para tu cuenta real.
cspm-automate.sh es el pipeline en sí, sin Terraform, sin crear ni destruir nada: Prowler escanea, se analiza, Cloud Custodian remedia, Prowler valida, Slack avisa. Es el que correrías contra tu propia cuenta AWS con tu propia infraestructura ya existente. Los dos scripts comparten la misma lógica desde una librería común (cspm-pipeline.sh), para no tener dos copias del mismo bug dando vueltas.
Antes de correr cspm-automate.sh contra una cuenta real:
Usá una cuenta de testing primero, no producción directamente.
Cambiá el tag
Project=cspm-demoencloud-custodian-policies/remediation-policies.ymlpor el que uses vos para identificar qué puede tocar Cloud Custodian.Corré
custodian run --dryrunantes de dejarlo remediar de verdad, para ver qué matchearía sin tocar nada.
Este es el primero de una serie sobre el ciclo completo. El siguiente entra en detalle en los resultados de Prowler y cómo priorizar qué remediar primero.


